
预测性维护——设备坏之前,它怎么知道的?
技术干货 · 预测性维护与设备管理
预测性维护
设备坏之前,它怎么知道的?
──────────────────────────────
维护方式三级跳 · 五大监测手段 · P-F曲线 · 四层架构 · 实战案例
类型:技术干货 | 适用:工业自动化/物联网开发从业者
关键词:预测性维护 · 振动监测 · P-F曲线 · 边缘计算 · 剩余寿命 · 工业物联网
⚡ 速读盒子 · 30秒看完核心
▸ 核心结论:预测性维护不是“预言设备哪天坏”,而是在P-F区间(劣化可检出→彻底损坏)内尽早发现异常,把抢修变成从容的计划检修——监测手段决定提前量,振动能提前数月
▸ 避坑要点:别全厂铺开(先按停机代价选关键设备)、监测频率必须短于P-F区间(月度巡检可能错过轴承2-4个月的劣化窗口)、只出数据不出工单的系统等于没有闭环
▸ 案例结果:窑尾风机轴承提前19天预警、错峰检修4小时搞定(抢修需停窑3天)、全年非计划停机从21次降到5次
每个工厂都有过这样的深夜:凌晨两点,车间的关键设备突然报警停机,维修班从被窝里爬起来赶到现场,拆开一看——轴承散架了。抢修三天,订单延误,全厂绩效泡汤。而事后复盘往往发现:这个轴承的劣化,早在几个月前就有征兆,只是没人“看见”。
设备不会突然坏,它只会“突然被发现坏了”。振动在升高、温度在爬坡、电流在波动——劣化是一条缓慢积累的曲线,人眼看不见,传感器看得见。预测性维护(Predictive Maintenance)干的就是这件事:用传感器持续监测设备状态,在故障发生前的窗口期就把问题揪出来。这不是科幻:麦肯锡2024年的基准报告给出的数字是,成熟的预测性维护能让停机时间减少35%-45%、维护成本降低25%-30%。
这篇文章前70%把预测性维护的原理讲透:维护方式的三级演进、五大监测手段怎么选、P-F曲线这个核心概念、四层技术架构怎么搭、实施路径怎么走;后30%用一个水泥厂的真实项目收尾——从58台全铺的失败,到聚焦8台关键设备的成功,弯路比捷径更值得学。
一、维护方式三级跳:从“坏了修”到“算着修”
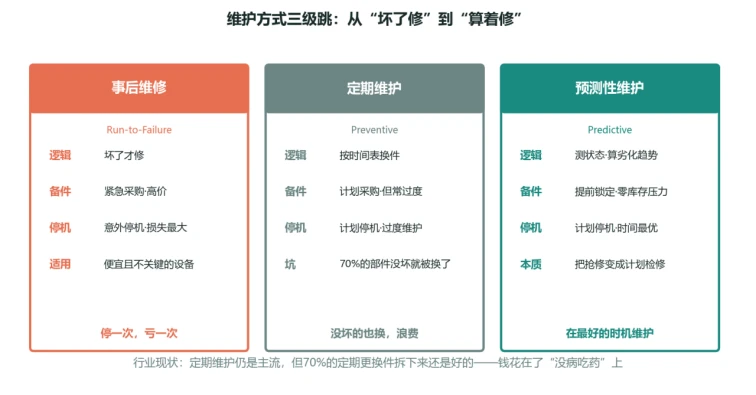
图1:维护方式三级演进——70%的定期更换件拆下来还是好的
工厂的维护方式,走过三级台阶。第一级,事后维修(Run-to-Failure):坏了才修,听起来愚蠢,但对便宜且不关键的设备(普通风机、照明回路)反而是最经济的——为价值两千元的设备配两千元的监测系统,本身就是笑话。第二级,定期维护(Preventive):按时间表更换部件,不管它坏没坏。这是当下绝大多数工厂的主流做法,但它有个公开的秘密:约70%的定期更换件拆下来还是好的——钱花在了“没病吃药”上;更尴尬的是,有些故障恰恰发生在两次维护之间,该停的照样停。
第三级,预测性维护(Predictive):不按时间表,按设备实际状态。持续监测振动、温度这些“体征”,发现劣化趋势后再安排维护——在最好的时机、用最小的代价干预。三级方式的对比:
维度 | 事后维修 | 定期维护 | 预测性维护 |
触发条件 | 坏了 | 到时间了 | 状态劣化了 |
停机性质 | 意外停机 | 计划停机(可能过度) | 计划停机(时机最优) |
维护成本 | 低(单次)高(总账) | 中·过度维护 | 最优 |
备件管理 | 紧急采购·高价 | 定期囤货 | 提前锁定·精益库存 |
适用对象 | 低值非关键设备 | 大多数设备的过渡方案 | 关键设备的最优解 |
为什么现在提预测性维护?因为两道门槛同时塌了。一是硬件:MEMS加速度计的价格较2020年下降约40%,工业级无线传感器节点已降到15美元以内——过去一套在线监测系统的钱,现在能装一个车间。二是算力:边缘网关本地就能跑频谱分析和机器学习模型,不用把原始数据全传云端(这个架构我们在工业网关篇讲过)。经济账算得过来,这事儿才成立。
Q: 我们厂做了定期维护几十年,有必要换预测性吗?
A: 先看两个数:你的非计划停机每年多少次?每次损失多少钱?汽车行业非计划停机一小时损失1.5万-2.5万元,半导体行业10万-50万元——如果你的关键设备一年意外停机三五次,每次几小时,这笔账大概率支持你上预测性维护。反过来,如果设备停了影响不大,定期维护甚至事后维修就是对的。预测性维护不是信仰,是算术题:监测成本要显著低于“停机损失×概率”才值得做。
二、五大监测手段:给设备配“听诊器”
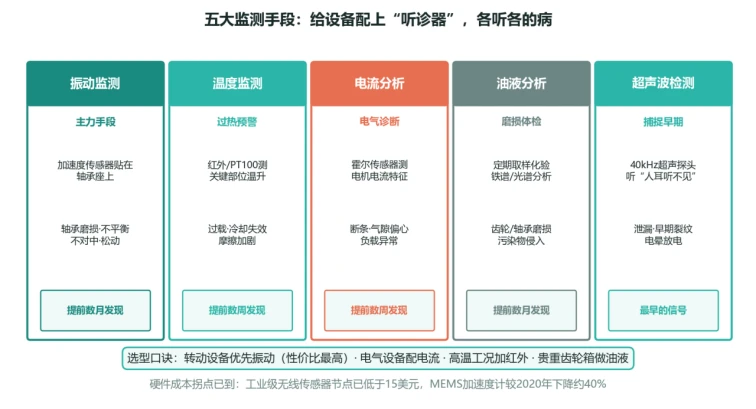
图2:五大监测手段——各听各的病,提前量差着一个数量级
医生看病要听诊、验血、拍片,设备诊断也有一套“体检套餐”,核心是五种手段。振动监测是绝对主力:加速度传感器贴在轴承座上,设备内部的每一次“不舒服”都会以振动特征频率的形式暴露——轴承磨损有特征频率,不平衡有1倍频特征,不对中有2倍频特征,松动有丰富的谐波。一台振动传感器加边缘分析,能覆盖转动设备80%的故障模式。
其余四个各有专属战场:温度监测抓过热(过载、冷却失效、摩擦加剧),红外测温还能远程扫全厂;电流分析是电气设备的“心电图”,电机断条、气隙偏心都会在电流频谱上留下特征;油液分析是贵重齿轮箱的“验血”,铁谱光谱能数出磨损颗粒的成分和数量,直接定位哪个部件在磨;超声波检测最灵敏,40kHz频段的“嘶嘶”声是人耳听不见的最早信号——泄漏、早期裂纹、电晕放电都从这里开始。
手段 | 监测什么 | 典型故障 | 提前量 | 成本 |
振动监测 | 轴承座振动频谱 | 轴承·不平衡·不对中 | 数月 | 无线节点<千元 |
温度监测 | 关键部位温升 | 过载·冷却失效 | 数周 | 红外点温仪数百元 |
电流分析 | 电机电流特征 | 断条·偏心·负载异常 | 数周 | 霍尔传感器+分析 |
油液分析 | 磨损颗粒成分 | 齿轮·轴承磨损 | 数月 | 送检制·按次付费 |
超声波 | 40kHz早期信号 | 泄漏·早期裂纹 | 最早 | 手持式/在线式 |
选型口诀一句话:转动设备优先上振动(性价比之王),电气设备配电流分析,高温工况加红外,贵重齿轮箱定期做油液。别贪多——监测手段是给故障模式配的,不是给预算配的。
Q: 无线传感器电池能用多久?经常换电池不是新的负担吗?
A: 主流工业级无线振动传感器的电池寿命已经做到3-5年。省电的秘诀在“按需采样”:不是7×24连续采集,而是每几小时唤醒一次采一段振动数据,边缘侧算完特征值就休眠——蓝牙/LoRa传一次数据只要几毫秒。对P-F区间数月的轴承劣化来说,几小时一次的采样密度绰绰有余。真正费电的“连续高频采样”只在确认异常后的“加密监测”阶段才启用,这是带自适应采样策略的系统的标准做法。
三、P-F曲线:预测的本质是“提前量”
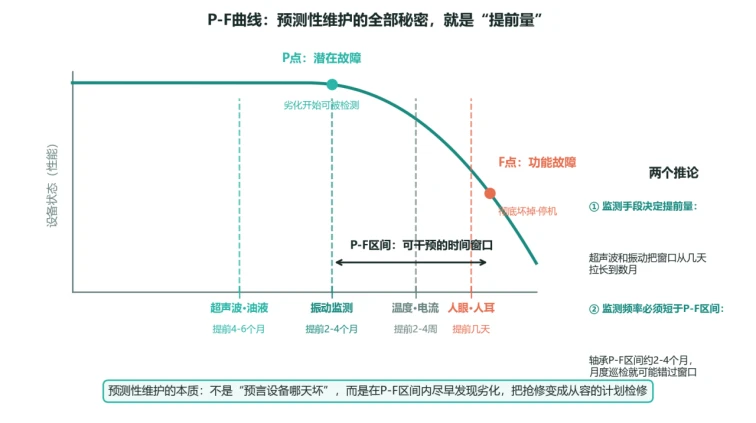
图3:P-F曲线——预测性维护的全部秘密,就是拉长可干预的时间窗口
这是全篇最重要的一张图,值得花五分钟看懂。P-F曲线描述设备的劣化过程:从某一点开始,设备状态开始下滑——这个点叫P点(Potential Failure,潜在故障),意思是“劣化开始能被检测到”;恶化持续加速,直到F点(Functional Failure,功能故障),设备彻底丧失功能。P点和F点之间的时间,叫P-F区间——这是人类唯一能干预的窗口。
关键洞察来了:不同的检测手段,能在P-F区间的不同位置“看见”劣化。超声波和油液分析最灵敏,提前4-6个月就能捕捉到苗头;振动监测稍晚,但也有2-4个月的提前量;温度和电流要到劣化中后期才有反应,提前2-4周;而人眼人耳——等你能看出设备不对劲(异响、发烫、冒烟)时,离彻底损坏往往只剩几天。同一个轴承,用不用振动监测,命运完全不同:一个是从容的计划检修,一个是凌晨两点的紧急抢修。
由P-F曲线能推出两条实战铁律:
❌ 铁律一 监测手段决定提前量
想要长的干预窗口,就得用灵敏的手段。选传感器时先问:这种故障模式的P-F区间多长?我要多早发现它?——答案决定手段,而不是反过来。
❌ 铁律二 监测频率必须短于P-F区间
轴承的P-F区间约2-4个月,如果你的巡检周期是三个月一次,就可能在两次巡检之间错过整个劣化窗口——从“还能撑”直接跳到“已经坏”。采样密度必须显著短于P-F区间,这是系统设计的硬约束。
Q: 那预测性维护到底能不能算出设备“还剩几天寿命”?
A: 能,但别迷信。剩余寿命预测(RUL)是学术界的热门方向,工程实践里它是个“置信区间”而非“精确日期”——模型会告诉你“按当前劣化速率,大概率还能运行40-60天”,而不是“3月17号坏”。工程上的正确用法:预测结果用来规划检修窗口(“赶下次错峰停产前处理”)和锁定备件,而不是赌它到底哪天坏。把RUL当参考系而不是倒计时,才是成熟用法。
四、四层架构与实施路径:别全厂铺开
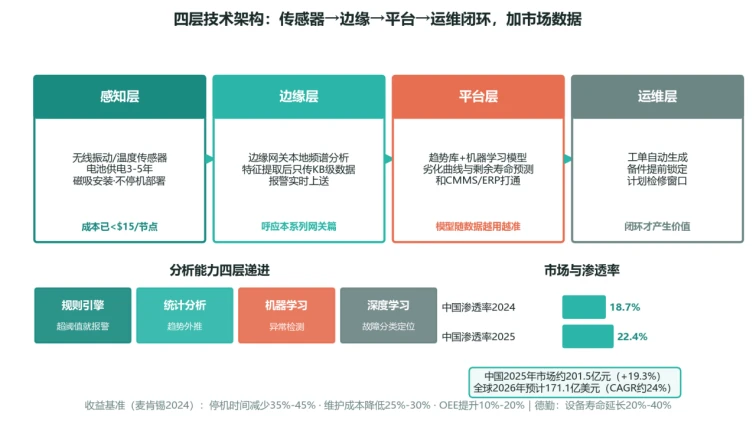
图4:四层技术架构与市场数据——数据来源:麦肯锡2024、德勤、行业报告2025-2026
四层架构:数据从传感器走到工单
成熟的预测性维护系统是四层结构。感知层:无线振动/温度传感器磁吸安装在设备上,不停机部署,电池撑3-5年。边缘层:边缘网关做本地频谱分析——原始振动数据量大(高频采样动辄MB级),提取成特征值(频谱峰值、峭度、包络能量)后只剩KB级,才值得往上传;报警则实时上送。平台层:云端做趋势库和机器学习模型,判断劣化曲线、估算剩余寿命,和CMMS/EAM设备管理系统打通。运维层:生成工单、锁定备件、安排计划检修——这一层最容易缺位,而缺了它,前面三层全是成本没有收益。
分析能力:四层递进,从规则到深度学习
分析算法不是一步到位的:第一层规则引擎(超阈值就报警)简单可靠,覆盖80%的场景;第二层统计分析做趋势外推(这个月的振动值比上月涨了30%);第三层机器学习做异常检测(正常工况的聚类模型,偏离即异常,不用标注故障样本);第四层深度学习做故障分类定位(轴承外圈/内圈/保持架,直接给出维修建议)。落地建议:从规则引擎起步,数据攒够了再上机器学习——没有历史数据训练的AI模型,是空中楼阁。
实施路径五步:先小后大,先关键后一般
第一步,关键设备识别:别贪心,全厂几百台设备里,停机代价Top 10%的设备贡献了80%的停机损失——先圈定它们。第二步,传感器部署:按故障模式配手段,转动设备振动优先。第三步,数据采集与存储:边缘预处理+云端历史库,至少攒3-6个月基线数据。第四步,模型训练与验证:先规则后模型,报警准确率不到70%别上线(狼来了效应会毁掉调度员对系统的信任)。第五步,运维流程集成:报警自动生成工单、工单闭环回流数据——这一步走完,系统才开始产生真金白银。
市场数据佐证这个赛道的爆发:中国预测性维护市场2025年约201.5亿元,同比增长19.3%;全球市场2026年预计171.1亿美元,年复合增速约24%。渗透率方面,中国工业领域2024年约18.7%,2025年约22.4%——也就是说,还有近八成设备停留在“坏了修”和“按时修”,这既是差距,也是空间。
Q: 预算有限,先从哪里下手?
A: 停机代价排序。拉一张表:每台设备意外停机1小时的损失(产值+抢修费+连带损失),乘上历史故障频率——排出Top 5。通常是窑炉主传动、主风机、主泵、压缩机这类“单点设备”(一停全线停)。给这5台配上振动+温度监测(预算几万元级),跑出效果和信任,第二年再扩到Top 20。一上来就要全厂数字化的项目,大概率死在第一年——下一个案例正是这么死的。
五、案例故事:58台到8台,一个水泥厂的弯路
客户背景
某水泥厂,4条生产线,年产能400万吨。设备管理的老三样问题:窑尾高温风机这类关键设备一年非计划停机21次,每次平均6小时;维修班疲于奔命,凌晨抢修是家常便饭;备件库存压了三千万——因为不知道什么会在什么时候坏,只能什么都囤。厂长带队去同行参观回来,拍板上预测性维护项目,预算充足,目标明确:三年内非计划停机减半。
一期翻车:58台全铺的教训
项目一期的方案书很漂亮:全厂58台主要设备全部安装传感器,建设“全厂设备健康大数据平台”。上线三个月,问题全来了:数据量爆炸(58台设备的高频振动数据,存储和传输成本远超预算);报警风暴(每天几百条报警,绝大多数是阈值定得不合理,调度员一周后就屏蔽了通知);没人看(平台有漂亮的驾驶舱大屏,但维修班长说“看不出和我的巡检表有什么区别”)。半年后复盘,一期的实际产出:一份月度报表。
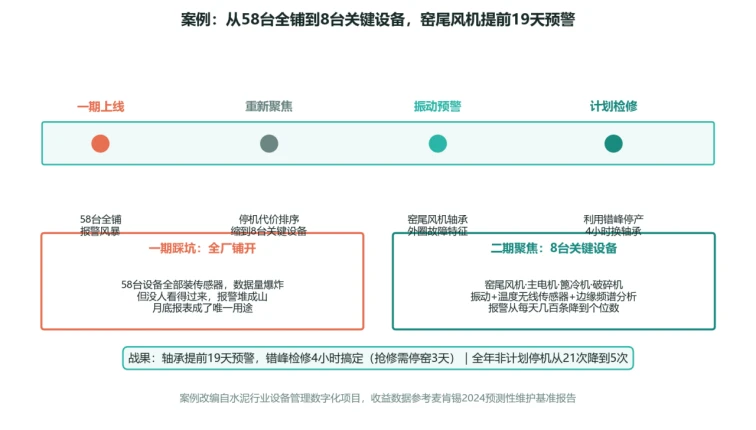
图5:项目时间线——从58台全铺到8台关键设备,提前19天预警轴承故障
二期重来:先算停机账,再谈传感器
二期换了打法。第一步不是选传感器,是算账:把58台设备按“停机代价×故障频率”排序——窑尾高温风机(一停整条窑保温受损,重启成本数十万)、回转窑主传动电机、篦冷机、破碎机等8台设备浮出水面,它们贡献了全厂80%的停机损失。就盯这8台。第二步按故障模式配手段:8台全是转动设备,振动+温度无线传感器(每台约2000元)+一台边缘网关本地跑频谱分析。第三步砍掉花哨功能:不上大屏驾驶舱,报警只推送给维修班长的手机,每天个位数——每条都值得跑现场。
高光时刻:提前19天的预警
上线第5个月,系统对3号窑尾高温风机驱动端轴承发出预警:振动频谱出现轴承外圈故障特征频率,幅值两周内爬升3倍。维修班长半信半疑地拿着频谱图去现场,听棒贴上去——确实有轻微异响。厂里正好两周后有错峰停产计划,备件(一个进口轴承,4.8万元)提前锁定。停产窗口4小时完成轴承更换,拆下来的旧轴承外圈果然已经剥落——再撑两三周就是散架。如果按原剧本演:非计划停窑3天,直接损失加保温能耗超过两百万。这一战之后,再没人质疑系统。
19天 | 4小时 | 21次→5次 |
轴承故障预警提前量(P-F区间内) | 计划检修耗时(对比停窑抢修3天) | 全年非计划停机次数(一期后年) |
三个教训值得所有预测性维护项目借鉴:
教训一:先停机代价排序,再选监测对象
58台全铺和8台聚焦,硬件投入差不多,效果天壤之别——因为8台关键设备的报警有人认真看。监测的价值密度=停机损失×发现概率,先把分母搞对。
教训二:报警质量决定系统生死
每天300条报警等于没有报警。宁可阈值定松一点少报,也别让调度员养成“已读不回”的习惯——信任崩塌的系统,救不回来。
教训三:没有工单闭环的监测是花瓶
一期的大屏驾驶舱好看但无用,二期的手机报警+工单流转朴素但救命。预测性维护的最后一公里不在算法在流程:报警→工单→检修→数据回流,闭环转起来,系统才有生命。
"“干了半辈子设备维修,我最怕的不是设备坏,是不知道它什么时候坏。现在系统提前19天告诉我,我睡得着觉了——就冲这个,这套系统值。"
—— 水泥厂设备维修班长
Q: 我们想启动预测性维护,第一步做什么?
A: 算停机账。把过去两年的设备故障记录拉出来:哪台设备停过、停了多久、损失多少——这一步不花钱,但大多数工厂答不出“停机损失Top 5设备”这个名单。有了名单,拿Top 3-5台做试点,每台配振动+温度无线传感器加边缘网关,三个月就能看到第一批预警。别急着建平台、上大屏——先让维修班长收到第一条有用的报警,项目就成功了一半。
六、总结:上马之前三问
回顾全文,预测性维护项目立项之前,问自己三个问题:
⚡ 一问值不值:停机损失×故障频率,监测成本要显著低于它才值得做——预测性维护是算术题不是信仰题。低值非关键设备,坏了修就是最优解。
🔍 二问看什么:按故障模式配监测手段:转动设备上振动(提前量数月)、电气设备配电流、贵重齿轮箱做油液——手段决定提前量,频率必须短于P-F区间。
🔁 三问闭不闭环:报警→工单→检修→数据回流,四环缺一不可。只出数据不出动作的系统,最终都会沦为“月度报表生成器”。
从产业看,硬件成本塌方(无线节点跌破百元)加边缘算力普及,让预测性维护从“大型企业的奢侈品”变成“中型工厂的日用品”;中国渗透率22.4%、全球市场年增24%的数字背后,是近八成设备还在等待它们的“听诊器”。而这个领域最稀缺的,从来不是传感器和算法,是把数据变成工单、把预警变成习惯的工程化能力。
你的工厂,还在等设备“突然坏”吗?
预测性维护方案评估 · 关键设备监测试点 · 设备管理数字化
技术干货 · 工业物联网系列
关注我们,持续拆解工业物联网技术的原理与实战
上一篇: 机器视觉——为什么你的检测项目总翻车?
下一篇: 数字孪生——产线调试为什么不用碰真机?