
Modbus避坑指南——为什么读出来全是乱码?
技术干货 · 工业物联网
Modbus避坑指南
为什么读出来全是乱码?
──────────────────────────────
帧格式拆解 · 寄存器模型 · 字节序陷阱 · 实战案例
类型:技术干货 | 适用:工业自动化/物联网开发从业者
关键词:Modbus · 寄存器 · 字节序 · 工业网关 · 设备上云
⚡ 速读盒子 · 30秒看完核心
▸ 本文结构:70%技术干货(RTU帧格式拆解+三种变体对比+寄存器模型+字节序陷阱+四个实战坑)+30%案例故事(30台PLC上云全流程)
▸ 核心结论:Modbus的坑高度集中在四处——地址偏移、浮点字节序、超时设置、写入安全,每一个都有明确判据与解法,不需要靠运气调试
▸ 避坑要点:协议地址要减1、字节序先确认再解析、超时分档设置、关键寄存器写入加安全锁
▸ 案例结果:30台PLC全部接入,5000个采集点位,单轮采集仅需2秒,断网自动缓存补传
如果你写过Modbus采集程序,大概率经历过这样的深夜:程序编译通过、串口线没问题、设备地址也没错,可读回来的数据要么是乱码,要么是"隔壁寄存器"的值,温度读出来是负数,压力读出来是天文数字。硬件查了个遍,最后发现问题出在一个字节的位置上。
更隐蔽的是超时问题:32台设备轮询,突然某台响应慢了,整个轮询周期从6秒拖到32秒,采集效率断崖式下跌。还有人调试时误写了一个寄存器,变频器频率从25Hz直接跳到50Hz,差点造成设备损坏。
这些坑不是玄学,而是Modbus协议设计的固有特性——只要搞懂帧格式、寄存器模型和字节序,每个坑都有明确的判据和解法。这篇文章前70%把Modbus的技术原理讲透:帧格式怎么拆、三种变体差在哪、寄存器模型怎么算、字节序怎么辨;后30%用一个真实的30台PLC上云项目验证:这些方法落地后是什么效果。
一、为什么Modbus能活40多年
Modbus诞生于1979年,由Modicon(现施耐德电气)发布,至今仍是工业自动化领域使用最广泛的现场总线协议。从PLC、变频器到传感器、电表,几乎所有工业设备都支持它。在物联网时代,Modbus更是连接存量工业设备与云平台的"桥梁语言"。
一个40多岁的协议为什么还没被淘汰?四个原因:
优势 | 具体表现 |
简单到极致 | 帧格式一目了然,任何工程师半天内可实现 |
完全开放 | 无专利、无授权费,标准免费公开维护 |
生态庞大 | 全球数亿台Modbus设备在运行 |
硬件无关 | RS-485、RS-232、TCP/IP上都能跑 |
市场数据也印证了它的生命力:据HMS工业网络年度报告,Modbus TCP在新安装节点中的全球市场份额稳定在17%左右,位居现场总线之首;国内Modbus模块近年年出货量保持近20%的增速——存量改造与低成本刚需,让这个"老协议"持续扩容。
Q: 都2026年了,Modbus会不会被Profinet、EtherCAT这些工业以太网淘汰?
A: 不会。高速运动控制确实是工业以太网的天下,但大量场景(抄表、温控、抄录产量)不需要微秒级实时,Modbus的性价比无可替代。更关键的是:国内上亿台存量设备都在说Modbus,设备上云的第一步就是把它们读懂——淘汰的不是协议,是不懂协议的人。
二、一帧数据长什么样:RTU帧格式拆解
先看最常用的Modbus RTU。一帧请求从左到右只有四个部分:从站地址、功能码、数据、CRC校验。主机发一帧,从机回一帧,一来一回完成一次读写。
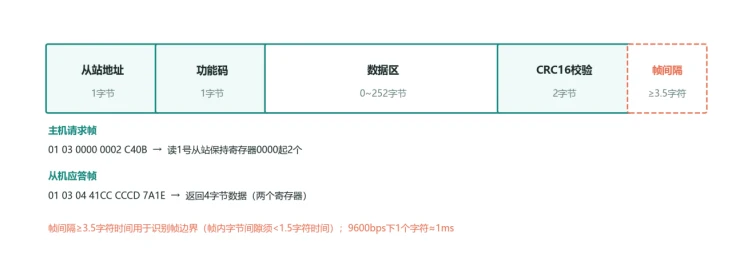
图1:Modbus RTU帧格式——地址、功能码、数据、CRC四段,靠帧间隔识别帧边界
这里有个容易被忽视的设计:RTU不用帧头帧尾字符,而是靠"静默时间"来识别帧边界——两帧之间必须空闲≥3.5个字符时间,而帧内相邻字节的间隙必须小于1.5个字符时间。9600bps下1个字符约1ms,也就是说:帧间隔≥3.5ms,帧内间隙<1.5ms。串口调试中出现的"偶发粘包、偶发断帧",多半是违反了这条时序规则。
CRC16校验是RTU可靠性的底线,算法本身很简单:
初始值 0xFFFF;对每个字节:CRC ^= 字节,然后循环8次——最低位为1则 CRC = (CRC >> 1) ^ 0xA001,否则 CRC >>= 1
Modbus家族有三种变体,共享同一套功能码和寄存器模型,差别只在传输层:
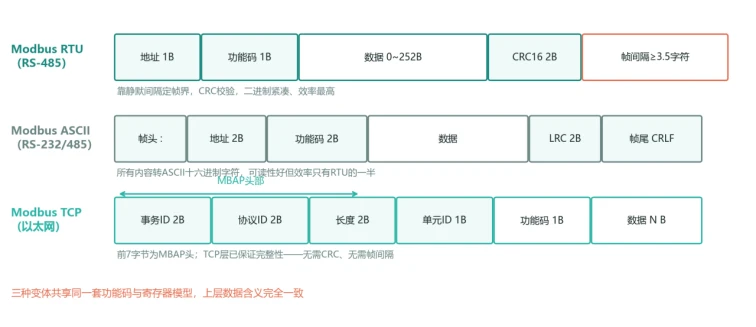
图2:三种变体帧结构对比——RTU靠静默间隔定帧界,ASCII靠帧头帧尾字符,TCP靠MBAP头中的长度字段
变体 | 物理层 | 帧定界 | 校验 | 典型场景 |
RTU | RS-485 | 静默间隔≥3.5字符 | CRC16 | 现场设备,最常用 |
ASCII | RS-232/485 | 帧头(:)与帧尾(CRLF) | LRC | 调试诊断,可读性好 |
TCP | 以太网 | MBAP头长度字段 | 无需(TCP保证) | 联网设备,上云首选 |
注意一个高频考点:Modbus TCP既不需要CRC,也不需要帧间隔——TCP本身已保证数据完整性,且MBAP头里的长度字段天然界定了帧边界。很多从RTU迁移到TCP的开发者还在自己算CRC、做静默检测,属于典型的"惯性踩坑"。
三、功能码与寄存器模型:地址偏移是第一坑
Modbus的操作全部通过功能码完成,常用的就8个:
功能码 | 名称 | 操作 | 典型场景 |
01 | 读线圈 | 读开关量输出 | 读继电器状态 |
02 | 读离散输入 | 读开关量输入 | 读按钮、限位状态 |
03 | 读保持寄存器 | 读16位可写值 | 读温度、压力设定值 |
04 | 读输入寄存器 | 读16位只读值 | 读模拟量测量值 |
05 | 写单线圈 | 写1个开关量 | 控制单个继电器 |
06 | 写单寄存器 | 写1个16位值 | 下发单个参数 |
15 | 写多线圈 | 批量写开关量 | 批量启停控制 |
16 | 写多寄存器 | 批量写16位值 | 批量下发参数 |
Modbus的数据模型不是"变量名",而是四类寄存器,每类有固定的地址段:
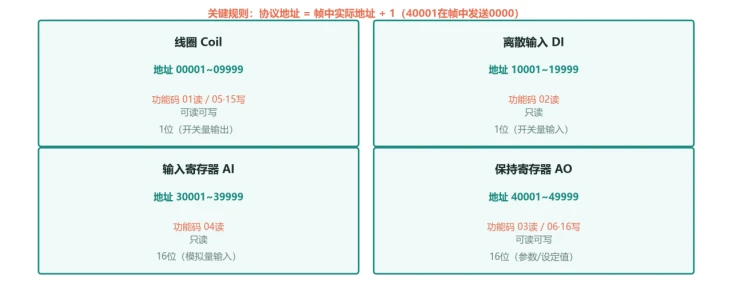
图3:Modbus四类寄存器模型——线圈、离散输入、输入寄存器、保持寄存器,各自对应固定地址段与功能码
最容易搞混的地方来了——地址偏移。手册上写"保持寄存器40001",但协议帧里实际发送的地址是0000:
协议地址 = 手册地址 + 1(40001在帧中发送0000,40010发送0009)。不同厂商手册习惯不同,有的标注从1开始,有的直接给协议地址——动手前必须先确认这一条。
四、字节序陷阱:乱码的真正元凶
Modbus寄存器是16位的,但工程数据经常是32位浮点数(温度、压力、电流),一个数要拆到两个寄存器里。问题就出在:两个寄存器、四个字节,先后顺序没有唯一标准。
以25.6为例,IEEE 754编码后字节序列是 41 CC CC CD,三种排布方式:
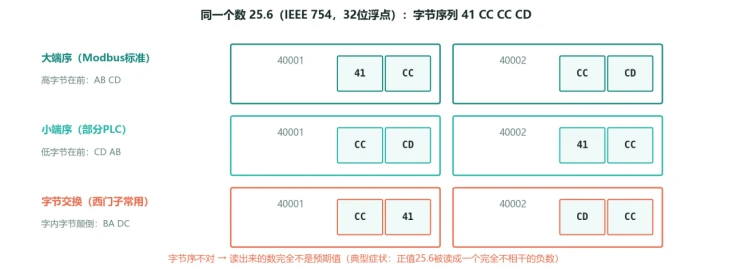
图4:同一个数25.6的三种字节序排布——大端序、小端序、字节交换,读错顺序数值完全不同
大端序是Modbus标准(高字节在前),但西门子PLC常用"字节交换"模式(字内字节颠倒),部分设备用小端序。字节序不匹配的症状非常有辨识度:正值读成离谱的负数、小数读成天文数字。判别方法也简单——先用工具读出两个寄存器的原始十六进制值,手工拼一遍,和设备面板显示值对得上,再写解析代码。
这是Modbus开发中出现频率最高的坑,没有之一。凡是"读出来全是乱码"的故障,先查字节序,能解决一大半。
五、四个实战坑:每一个都来自真实项目
把前面零散的坑汇总成清单,每一个都有明确的症状和解法:
❌ 坑一 寄存器地址偏移:手册地址从1开始,协议帧从0开始。没做减1偏移,读到的全是相邻寄存器的数据——温度通道读到了压力值。
正确做法:协议帧中所有地址统一减1;接入新设备前先核对厂商手册的地址标注习惯。
❌ 坑二 浮点数字节序:西门子是"字节交换"模式,标准Modbus是大端序。不做转换,读到的全是乱码或离谱负数。
正确做法:采集前先读原始寄存器值手工比对,确认字节序后在代码中做swap;字节序作为点位配置的一项,而不是写死在代码里。
❌ 坑三 超时时间一刀切:默认超时200ms,某台设备响应慢就频频超时;把超时统一改到1秒,32台设备轮询从6秒恶化到32秒。
正确做法:超时分两档——正常设备200ms、已知慢速设备1秒;连续超时3次自动降速,恢复后自动回档。
❌ 坑四 写入操作无安全锁:Modbus没有任何鉴权机制,任何主机都能写任意寄存器。调试时误写一个字,变频器频率从25Hz跳到50Hz,差点损坏设备。
正确做法:关键寄存器写入前加二次确认逻辑,写入后立即回读验证;生产网络上严格限制可写主机。
六、案例故事:某汽车零部件厂30台PLC上云
客户背景
某汽车零部件厂注塑车间,30台注塑机均由支持Modbus TCP的PLC控制。厂里要做产能与能耗分析,第一步就是把30台设备的数据实时接入云平台。
遇到的问题
三个核心痛点:一是数据靠人工抄表,每天一次、滞后且易错;二是曾有供应商做过单台采集脚本,30台设备30套脚本各自为战,点位一改就要挨个改代码;三是踩遍了前文的坑——温度读出来是乱码(字节序)、换一台设备数据错位(地址偏移)、个别老设备一上线整个轮询就变慢(超时)。
诊断与设计
技术团队评估后放弃"每台设备一套脚本"的老路,改为统一网关方案:网关作为Modbus TCP Client轮询30台PLC,同时作为MQTT Client上云。点位用YAML配置文件定义(名称、从站号、地址、数据类型、字节序、采集周期),改点位只改配置不动代码;读取用批量功能码(一次读连续多个寄存器,减少通信次数);字节序按设备型号做适配表;超时分档并自动降速;关键寄存器写入加二次确认与回读验证。
部署过程
先选3台设备试点一周,验证字节序适配与轮询稳定性;确认无误后全量部署到30台,全程不停产,现场实施两天完成。
最终数据结果
30台 | 5000点 | 2秒 |
PLC全部接入(原人工抄表) | 采集点位(原每天抄1次) | 单轮采集周期 |
具体来看,改造实现了三个层面的提升:
数据从"每天一次"到"每2秒一轮"
5000个点位2秒完成一轮采集,温度、压力、产量、报警实时上云,产能与能耗分析第一次有了分钟级的数据底座。
改点位从"改代码"到"改配置"
YAML点位配置让新增设备、调整点位变成配置工作,现场工程师即可完成,不再依赖开发排期。
断网不再是数据黑洞
网关本地缓存断网期间的数据,网络恢复后自动补传,云端曲线不再出现缺口;误写风险也被安全锁挡在门外。
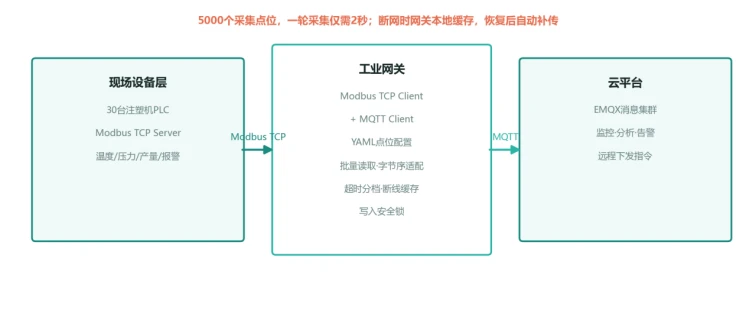
图5:Modbus TCP转MQTT上云架构——网关承担协议转换、批量采集、断线缓存与写入安全
"以前每台设备一套采集脚本,改一个点位要动代码,谁都不敢碰。现在网关统一采集,改配置就行,数据还比人工抄表准。"
—— 该厂设备科负责人
Q: PLC本身就支持Modbus TCP,直接上云行不行,为什么还要经过网关?
A: 不建议。一是安全:Modbus没有任何鉴权与加密,把PLC直接暴露到公网等于裸奔;二是可靠性:断网期间数据会永久丢失,网关可以本地缓存补传;三是工程性:点位管理、字节序适配、批量轮询、协议转换这些活,总得有个地方干——与其散落在30套脚本里,不如收敛到一台网关上。
七、总结:Modbus的坑,都是"可预判"的坑
回顾全文,Modbus开发避坑就是三个"搞清":
⚡ 先搞清模型:四类寄存器、八个功能码、地址减1偏移——这是读写正确的基础。
🎯 再搞清字节序:大端、小端、字节交换三种排布,先读原始值手工比对,再写解析代码。
🛡️ 最后搞清边界:超时分档防轮询雪崩,写入安全锁防误操作——让系统在异常条件下也能稳住。
从案例的结果看,把这三个"搞清"落到一台网关上,30台PLC、5000个点位,单轮采集2秒,断网自动补传。Modbus诞生40多年依然是工业通信的事实标准,不是因为它先进,而是因为它简单、开放、可依赖——前提是,你得真正读懂它。
你的产线,还有多少台设备的 Modbus 数据躺在寄存器里没人读?
Modbus避坑 · 30台PLC上云 · 5000点位 · 单轮2秒
技术干货 · 工业物联网系列
关注我们,持续拆解工业物联网技术的原理与实战